12 Nisan 2016 Salı

SQL Server 2016 Yenilikleri - 3 (Operational Analytics)

SQL Server 2016 Yenilikleri Serimizin ilk iki yazısında InMemory OLTP ve InMemory DW (ColumnStore) alanında duyurulan gelişmelerden bahsetmiştik. Yazılara bir göz atmak isterseniz aşağıdaki linkleri kullanabilirsiniz

InMemory DW (ColumnStore) tarafındaki gelişmeler için:
http://abdullahkise.blogspot.co.uk/2016/03/sql-server-2016-yenilikleri-1-in-memory.html

InMemory OLTP (Memory Optimized) tarafındaki gelişmeler için :
http://abdullahkise.blogspot.co.uk/2016/03/sql-server-2016-yenilikleri-2-in-memory.html

Bu yazımızda iki alandaki gelişmeleri bir araya getireceğiz ve gerçek zamanlı analizler yapabildiğimiz 'Operational Analytics' konseptinden bahsedeceğiz.


Önce biraz geçmişe bakalım


Geleneksel bir sistemde Insert, Update, Delete iş yükünü karşılayan veritabanlarında normalizasyon kuralları uygulanır. I,U,D işlemlerinin optimum kalitede yapılabildiği bu veritabanı modelleri OLTP kısaltmasıyla anılır. Sıklıkla iş süreçlerinin takibi için kullanılan sistemler zamanla çeşitlenir ve farklı mantıklarda tasarlanmış birden fazla OLTP kaynak, yamalanmış sürecin bir parçası olur.

Sonra bu kaynaklardaki veriler iş kararları vermek amacıyla ele alınmak istendiğinde işin içinden çıkılamaz. Çünkü artık kaynaklar arası bir standart kalmamış, veriler kirlenmiştir. Bu durumda devreye veriambarları girer. Veriambarları (DW, DWH) analiz etmeye yani SELECT etmeye en müsait şekilde modellenmiş veritabanlarıdır. Veriler  ETL dediğimiz veri aktarım ve dönüştürme süreçlerinden geçirilerek bir takım ara katmanlara, sonrasında da veriambarına aktarılır.

Veriambarlarında verinin kolayca analiz edilebileceği Dimensional Model yaklaşımı benimsenir. Artık elimizdeki sistem bir OLAP sistemi olarak anılır. Tabi daha fazla hız ve esneklik bekleyenler için bir adım daha atılır; OLAP Cubelerinin oluşturulması (Multidimensinal, Tabular). En basit söylemle Cubeler veriyi, yapıyı ve ek hesaplamaları üzerinde tutar. Böylece önceden hazırlanmış veriye bir nevi koordinat sistemi mantığıyla erişmek mümkün olur. Tekrar tekrar hesaplama yapılmaz. Bundan sonraki aşamada da veri bir takım raporlama araçlarıyla görüntülenebilir.

Bahsettiğimiz bu geleneksel sürecin avantajları olduğu gibi dezavantajları da var. Bu dezavantajlara kısaca değinelim:

  • ETL İşlemlerinin yükü:
Öncelikle verileri temizlemek ve standartlaştırmak için ETL işlemleri yapmanız gerekir. Bu işlemler bazen çok karmaşık olabilir. Bunun yanında sisteme girilen verinin raporlanması için belli bir süre geçmesi gerekir. Bazen bu gecikme dakikalar seviyende, bazen de günler seviyesinde olabilir.

  • Küplerin 'Process' edilmesi:
Kaynaklardan veriambarına yapılan aktarımlar ETL süreçlerinde ele alınır. ETL süreçlerine benzer şekilde veriambarından 'OLAP Cube'lerine de veri aktarımı yapılır. Bu sürece Cube Processing denir. Benzer şekilde burada da bir karmaşıklık ve gecikme söz konusudur.

  • Yazılım, Donanım, Geliştirme ve Bakım planı:
Sistemdeki karmaşıklık hem geliştirme hem de bakım planının ciddi şekilde ele alınmasını gerektirir. Verinin çeşitli kademelere aktarılması ve çoğaltılması yazılım/donanım yatırımı konusunda titiz olmayı gerektirir.

Özetlersek; geleneksel analitik sistemlerde veri çoklanır ve verinin gelmesi için zamana ihtiyaç vardır. Maliyetli ve yavaş (en azından gerçek zamanlı sayılmaz) bir sistem.

Tabi ki, eğer birden fazla kaynak varsa, bunları bir araya getirmek için veriambarı tasarlamak çoğu zaman en sağlıklı ve en güvenli yol olur. Bazen bu adım atılmadan sistemde performans artışı sağlanamayabilir. 

Index, paralelizm vb. konfigurasyonların yetmediği yerlerde okuma ve yazma iş yüklerini ayırmak genellik net çözümdür.

Veriambarı zorunluluğunun olduğu sistemlerde gerçek zamana yakın bir raporlama yapmak için veriambarından raporlama yapılır. OLAP Cube'lerinin avantajlarından faydalanmak isteniyorsa, Multimensional için sadece yapının korunduğu, verinin veriambarından her defasında temin edildiği ROLAP modu, Tabular için benzer şekilde verinin veriambarından temin edildiği DirectQuery modu tercih edilir. Böylece yapı her ne kadar OLAP Cube olsa da veri veriambarının performansına ve güncelliğine bağlı olarak sunulur. Geleneksel sistemlerin gerçek zamanlı raporlama konusunda geldiği nokta özetle buydu. 


Oyuna sonradan dahil olan çözümlerle düşünelim


SQL Server 2012 ile duyurulan 'ColumnStore Index'ler zamanla gelişti ve Select konusunda 100 kat performans sunan InMemory DW çözümü, SQL Server 2016 ile birlikte son derece başarılı bir noktaya ulaştı. Benzer şekilde SQL Server 2014 ile birlikte duyurulan InMemory OLTP'de 'Memory Optimized Table'lar üzerinden INSERT, UPDATE, DELETE konusunda 30 kat'a varan performans sunabildi ve geliştirilerek SQL Server 2016 ile birlikte bir çok prangadan kurtuldu.

Artık Disk Based bir tablo ve/veya Memory Optimized bir tablo üzerinde RowStore veya ColumnStore index kullanmak mümkün. Bu indexleri belli şartlar altında çeşitli kombinasyonlarda kullanarak hem yazma iş yükünü hem de okuma iş yükünü aynı tabloda toplayabiliriz. Bu durum yüksek performansın sonucu olan gerçek zamanlı raporlama yapmaya imkan verir. Artık raporlarınızı ister bu tablodan isterseniz direk tabloya erişimle veri getirecek şekilde konfigure edilmiş OLAP Cubelerden gerçek zamanlı olarak elde edebilirsiniz. Böylece bir takım senaryolar için ETL ve DW süreçlerine ihtiyacınız kalmaz. Veri doğrudan gerçek zamanlı olarak kaynaktan temin edilir.


Nasıl yapılır?

  1. Operasyonel işlemlerin yüklendiği tablo RowStore veya Memory Optimized olabilir.
    • INSERT, UPDATE, DELETE performansını arttıracak bir çok ipucu var. Mesela BTree indexleri kaldırabilirsin (bunun yerine ColumnStore tavsiye edilir.), constrainleri kapatabilirsin, flagler kullanabilirsiniz vs.
    • Memory Optimized tablolar IUD işlemlerinde 30 kat performans sunar. Kısıtlar göz önünde bulundurularak bu tür tablolar tercih edilebilir.
  2. Yavaş değişen (Warm) veriler için filtrelenmiş (Where koşulu ile belli şarttaki verilerin indexlendiği) Nonclustered ColumnStore indexler tanımlanabilir (Şimdilik Memory Optimized tabloda filtreleme özelliği kullanılamıyor). 
    • Mesela girilen siparişlerden sadece teslimat bekleyenleri filtrelemek isteyebilirsiniz. Sadece ihtiyacınız olan aralık indexlenmiş olur. Böylece fragmantasyonu en aza indirmiş olursunuz. Daha az veri yazıldığı için yazma performansına olan negatif etki en aza iner.
    • İhtiyaç duyulan diğer noktalar için de RowStore indexler kullanım amacı ve yetenekleri göz önünde bulundurularak tanımlanabilir.
  3. Çok sık güncellenen kısım için (Hot) Btree index, daha az güncellenen (Warm) veya neredeyse hiç güncellenmeyen kısım için (Cold) (Daha çok okuma yapılan) ColumnStore index tanımlanabilir. 
    • Burada asıl mesele doğru indexi fazla yük getirmeyecek şekilde doğru aralık için kullanmaktır. Tabi ek olarak Query Optimizer da en verimli yolu tercih edecektir.
    • ColumnStore indexlerdeki fragmantasyonu azaltmak için COMPRESSION_DELAY ifadesi ile sıkıştırma işlemini dakika cinsinden geciktirmek mümkün. Böylece her 1 milyon satır için sıkıştırma işlemi yapmak yerine, istenen aralıklarda buna vakit ayrılabilir.
Bir sipariş sistemini düşünürsek:
  • Alınan siparişler - Çok sık veri girişi olur (Hot Data) - Memory Optimized tablo önerilir.
  • Teslimatı bekleyenler - Zaman zaman durumlarında değişiklik olur (Warm Data) - Filtrelenmiş NonClustered indexler önerilir.
  • Teslim Edilmiş Siparişler - Neredeyse hiç değişiklik olmaz (Cold Data) - Filtrelenmiş ColumnStore önerilir.

Özetlemek gerekirse;

Senaryonun gereklilikleri göz önde bulundurularak, InMemory OLTP, InMemory DW ve geleneksel performans arttırıcı yöntemler bir araya getirilirse maksimum yazma ve maksimum okuma avantajı elde edilebilir. Böylece ETL ve DW süreçlerine gerek kalmadan yazma ve okuma iş yükünü üstlenebilen bir tablo üzerinden gerçek zamanlı raporlama yapmak mümkün olur.

SQL Server 2016 ile birlikte çok gelişmiş araçlar elimizde olacak. Bunları doğru şekilde bir araya getirdiğimizde etkileyici kazanımlar elde edeceğimiz aşikar.


28 Mart 2016 Pazartesi

SQL Server 2016 Yenilikleri - 2 (In-Memory OLTP Geliştirmeleri)

SQL Server 2016 yenilikleri serisine devam ediyoruz.

Serinin bir önceki yazısında In-Memory DW konseptinde yani ColumnStrore indexlerde yapılan geliştirmelere göz atmıştık. İncelemek isterseniz şu linki takip edebilirsiniz:
http://abdullahkise.blogspot.com/2016/03/sql-server-2016-yenilikleri-1-in-memory.html

Bu yazımızda In-Memory OLTP konseptinde yapılan geliştirmelere odaklanacağız.

In-Memory OLTP, SQL Server 2014 ile birlikte karşımıza çıktı. Bu teknoloji sayesinde INSERT, UPDATE, DELETE işlemlerinde 30 kata varan performans elde etmek mümkün oldu. Konu hakkındaki tüm ayrıntılı bilgileri daha önce paylaşmıştık. Şu linkten inceleyebilirsiniz :
http://abdullahkise.blogspot.com/2014/01/microsoft-sql-server-2014-ctp2.html


Yukarıda linkini verdiğimiz yazımızın sonundaki cümle ile bir özet geçelim :

"Lock ve Latch olmayan. ACID kurallarını destekleyen ve multi-version optimistic concurrency control prensibi ile transactionları yöneten. Verinin memoryde tutulduğu. Arka planda C ve FileStream nesnelerinin kullanıldığı mevcut Database Engine’e entegre yeni bir teknoloji. Bu teknoloji INSERT, UPDATE, DELETE performansını 30 kat arttırmak konusunda iddialı."

Testlerimizde de gördük ki bu teknoloji sayesinde OLTP işlemlerinin performansı etkileyici şekilde artıyor. Ancak paylaşılan istatistiklere göre uyumlu veritabanı oranı %5 civarında görünüyordu. Bunun  nedeni kısıtların çok fazla olmasıydı. Neyse ki SQL Server 2016 ile birlikte bu kısıtların bir çoğundan kurtulduk. Son durumda uygulanabilme oranının bir hayli yükseleceğini düşünüyoruz.

Teknoloji trendinin bizi getirdiği noktadan baktığımızda git gide daha modern donanımların yaygınlaşacağını göreceğimiz çok açık. Artık eskiye nazaran daha fazla CPU ve daha fazla memory ile çalışabiliyoruz. Rekabetin artması birim zamanda verilen karar miktarının artmasına sebep oluyor. Karar verme ve operasyon hızının artması için de veri analizinde baş döndürücü bir hıza ihtiyaç duyuluyor.

Şimdilerde devler teknoloji ve matematiği bir araya getirerek bu konularda pratik çözümler sunmaya çalışıyor. Bu çabanın sonucu olan In-Memory OLTP sayesinde RDBMS sistemleri yeni dünya ihtiyaçlarına cevap verebilir hale gelmektedir. Gerçek zamanlı ve/veya düşük gecikmeli analiz, raporlama çözümleri Microsoft, Oracle, IBM vs. gibi bir çok dev tarafından tanıtılmaktadır. Microsoft tarafına odaklanırsak; RDBMS sistemlerinin yaygın, başarılı ve akılda kalıcı çalışma şeklinde pek bir değişiklik yapmadan In-Memory OLTP yi kullanmak mümkün.

Gelelim SQL Server 2016 ile birlikte duyurulan bazı önemli In-Memory OLTP geliştirmelerine;


  • In-Memory OLTP kapsamında tanımlanan tabloların (Memory Optimized) maksimum boyutu 256 GB'dan 2 TB'a yükseltildi.
  • Artık tablo, procedure, index için ALTER komutları kullanılabilmektedir. Yani Schema da sonradan değişiklik yapılabilir.
  • Yeni versiyonda Natively olarak compile edilmiş (C dll) scaler fonksiyonlar tanımlanabiliyor.
  • İç içe Natively Compile procedureleri kullanmak mümkün.
  • Artık DML trigger tanımlanabilmekte.
  • TDE Encryption bu versiyonda destekleniyor.
  • Multiple Thread ve Parallel Plan geliştirmeleri ile bir önceki versiyona göre çok daha daha fazla performans elde etmek mümkün.
  • OUTER JOIN, UNION, DISTINCT, SubQuery, FOREIGN KEY, CHECK, UNIQUE constraint ve NULL kolon desteği mevcut.
  • Nihayet Memory Optimized tablolarda ColumnStore index tanımlanabiliyor. Bu hem yazma hem de okuma performansında şaşırtıcı bir artışın olacağı anlamına geliyor.
  • Saniyede 1.2 milyon transaction veya 900 MB/s veri yazma hızına erişilebiliyor.
Şu linkten In-Memory OLTP ile birlikte desteklenen ve desteklenmeyen veritabanı özelliklerini inceleyebilirsiniz: https://msdn.microsoft.com/en-us/library/dn133189.aspx

In-Memory OLTP'nin genel kullanım paternlerine şu linkten erişebilirsiniz:
https://msdn.microsoft.com/library/dn673538.aspx

Yenilikleri buraya kadar özetlersek;

In-Memory OLTP sayesinde INSERT, UPDATE, DELETE performansı 30 kat artıyor. Bu teknojide verinin direk memoryden sunulması, lock ve latch olmaması SELECT performansında da dikkat çekici bir artış sağlıyor. Ancak SELECT performansını asıl arttıran In-Memory DW başlığı ile gelen ColumnStore indexler olmuştur. Bu indexlerin sunduğu performans artışı ise yaklaşık olarak 100 kattır.

In-Memory OLTP ile In-Memory DW bir araya geldiğinde ise ortaya Operational Analytics adı ile duyurulan yenilik çıkıyor. Etkileyici bir tasarım. Bir sonraki yazımızda bu konuya odaklanmayı planlıyorum.

22 Mart 2016 Salı

SQL Server 2016 Yenilikleri - 1 (In-Memory DW - Updatable ColumnStore Indexes)

Bu sene SQL Server 2016 ile birlikte veritabanı dünyamıza heyecan veren yeni özellikler dahil oluyor. Microsoft'un son bir kaç senedir depar attığı Advenced Analytics ve Big Data konseptlerinin etkisini SQL Server ürününde de görmek bizleri mutlu ediyor.

Bazı özellikler önceki versiyonlardaki haline göre geliştirilmişken, bazı özellikler tamamen yeni. Özellikle önceleri sadece appliancelarda var olan Polybase engineı şimdi SQL Server'ın kurulabildiği tüm cihazlarda kullanılabilir durumda. Bu özellik büyük veri ile ilişkisel veritabanının birlikte çalışmasına olanak tanıyor. Hatta veritabanı ile çalışma alışkanlıklarınızı açık kaynakta olduğu gibi dramatik şekilde değiştirmenize gerek kalmadan bunu yapabiliyorsunuz.

SQL Server 2016'da bir çok etkileyici özellik mevcut. İşte bazıları;

  • Open Source R desteği ile analitik çalışmalarınızı yaygın ve güçlü bir dille gerçekleştirmeniz artık mümkün. 
  • Çok az maliyetle verilerinizi daima şifreli tutabilir ve sadece istediğiniz uygulamalarda şifresiz görüntüleyebilirsiniz.
  • Alışkın olduğumuz SSRS ile DataZen bir araya geldi. Böylece hem klasik raporlama hem de Mobile raporlama yaparak bunları tek bir çatı altında toplamak artık mümkün.
  • Geliştirilmiş In-Memory konsepti ile operasyonlarnıza ait verileri gerçek zamanlı olarak analiz edebilir ve raporlayabilirsiniz.

Biz de bu yazımızda In-Memory DW - Updatable ColumnStore Indexes yeniliklerine yoğunlaşacağız.

ColumnStore indexi SQL Server 2012 ile birlikte duymaya başladık. İlk olarak Update edilemeyen NonClustered ColumnStore index ile tanışmıştık. Sonra SQL Server 2014 ile birlikte Update edilebilir Clustered ColumnStore index ile tanıştık. Önceki verisyonlarda bir çok kısıt mevcuttu. 

Daha önceki yazımızda konu hakkında bir hayli bilgi vermiştik. ColumnStore indexler hakkında şu yazımızı incelemenizi tavsiye ederim:


Bu konuda bir de webcastimiz vardı:


Biz bu yazımızda daha çok yeni özelliklere yoğunlaşacağız.

ColumnStore indexler, RowStore indexlere göre açık ara performanslı. İstatistikler vermek gerekirse; 100 kata varan hız, 15 kata varan sıkıştırma elde etmek mümkün. Önceki yazımızda belirtiğimiz gibi 100 milyon satırın 30 dakika yerine 2 veya 3 saniyede elde edildiği referanslar arasında mevcut.

Bu performans farkını şu 3 özellik üzerinden önceki yazımızda açıklamıştık:
  1. Fiziksel Yapısı : Genelde sorgularımız kolon bazlı olur. RowStore indexler tüm satırı indexlerken, ColumnStore indexler sadece ilgili kolonun verilerini indexler. RowStoreda kullanılan pagelerine yerine ColumnStoreda segmentler kullanılır ve segmentler yüksek sıkıştırma özelliği sayesinde çok daha az yer kaplar. Böylece tam olarak ColumnStore indexlerden istediğimiz veriler elimize ulaşır. RowStoredaki gibi ilgilenmediğim kolonların olduğu pagelerde vakit kaybedilmez.
  2. Batch Mode : Normalde Query Optimizer verileri satır satır işler. Ancak gelen SQL Server 2012 ile birlikte bazı sorgu operatörleri bir grup satırı (çoğu zaman 900 satır) birlikte işleyebilecek şekilde tasarlanmıştır.
  3. Segment Eleme: Sayısal ve tarihsel alanlarda işe yarayan bu özellik sayesinde sadece verdiğimiz aralıkta bulunan verilerin olduğu segmentlere gidilmektedir. Böylece daha az IO yapılır. Her bir segmentte minimum maksimum değerin metadata olarak tutulması buna imkan verir. Eğer istenen değer bu aralıkta değilse segment elenir. Sadece şartımıza uyan segmentler belirlenerek içeriği okunur.

Gelelim SQL Server 2016 ile birlikte karşımıza çıkan ColumnStore indexlere:


  1. Performans farkını ortaya çıkaran yukarıdaki 3 özellik aynı şekilde işliyor. Buna ek olarak yeni Batch Mode çalışma desteği veren operatörler duyuruldu. Bunlar: SORT, COUNT/COUNT, AVG/SUM, CHECKSUM_AGG, STDEV/STDEVP, COUNT, COUNT_BIG, SUM, AVG, MIN, MAX, CLR, CHECKSUM_AGG, STDEV, STDEVP, VAR, VARP, GROUPING, LAG, LEAD, FIRST_VALUE, LAST_VALUE, PERCENTILE_CONT, PERCENTILE_DISC, CUME_DIST, PERCENT_RANK
  2. Artık ColumnStore (Clustered,NonClustered) indexler update edilebiliyor. Yani veri girişi sırasında indexi kaldırmaya gerek kalmıyor.
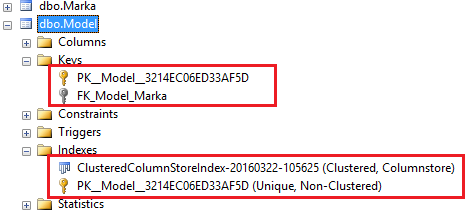
  3. Bu yeni versiyonla birlikte ColumnStore indexlerin bulunduğu tablolarda Pimary Key ve Foreign Key kullanılabilmektedir. (RC0'da test edecek olanlar PK'yı Heap üzerinde, FK'yı da ColumnStore indexten sonra tanımlamalılar.) PK oluşturken Clustered index otomatik oluşacaktır. Clustered yerine NonClustered oluşturalım ki Clustered ColumnStore index ile çakışmasın. Yani PRIMARY KEY NONCLUSTERED ifadesi ile PK oluşturulmalıdır. 
  4. Clustered ColumnStore indexten sonra RowStore (btree) index tanımlamak daha önceki versiyonlarda mümkün değildi. SQL Server 2016 ile birlikte artık hem Clustered ColumnStore hem de birden fazla NonClustered RowStore index tanımlamak mümkün.
  5. Yeri geldiği için hatırlatalım; bir tabloda tek bir Clustered (ColumnStore veya RowStore farketmez) index bulunabilir. Ayrıca bir tabloda birden fazla ColumnStore index tanımlanamaz.
  6. Artık NonClustered ColumnStore indexler filtrelenerek daha efektif kullanılabilmektedi.
  7. Clustered ColumnStore index, Memory Optimized (In-Memory OLTP) tablolarda tanımlanabilmektedir. (RC0'da test edecek olanlar önce Clustered ColumnStore indexi tanımlamalılar.)
  8. Storege Engine seviyesinde yapılan bir diğer geliştirme ise Pushdown (Aggregate Pushdown, String Predicate Pushdown) özelliğidir. Bu özelliği şöyle açıklayalım; Önceki yazımızda da geçtiği üzere veriler segmentlere dönüştürlürken encoding bilgisinin tutulduğu Dictionary nesneleri de oluşur. Segmentler, Dictionary'da tutulan gerçek verilerin giriş numaralarını içerir. Bu teknik sayesinde tekrar eden verilerle ilgili ciddi sıkıştırma performansı elde edilebilir. İki tür Dictionary nesnesi vardır. Primary Dictionary : tüm segmentler tarafından kullanılır. Secondary Dictionary : Birden fazla segment (aynı kolona ait) tarafından paylaşılır. Her zaman Secondary Dictionary kullanılmayabilir. Bazı durumlarda devreye giren Pushdown özelliği sayesinde kritere uygun satırlar Dictionary seviyesinde taranır. Diğer satırlar segment seviyesinde taranır ve filtrelenir. Bu çalışma şeklinin performansı SQL Server 2014 ile karşılaştırıldığında sonuçlar şaşırtıcı derecede farklı olur.         
Aynı sorgu üzerinden testimizi gerçekleştirdiğimizde, SQL Server 2016 istenen sonuçları açık ara önde sunabiliyor.

ColumnStore indexlerin sorgulama performansını incelemek isterseniz şu linke bir göz atabilirsiniz:

Sonuç olarak SQL Server 2016 versiyonu ile birlikte ColumnStore indexlerde hem performans bakımından hem de fonksiyonalite bakımından ciddi iyileştirmeler oldu. Diske bağımlılığın minimuma düşürülmesi hem operasyonel anlamda hem de analitik anlamda iş süreçlerine ciddi katkısı olmaktadır. Bu iyileştirmelerin yeni gelen diğer özelliklere de etkisi var. Sonuçlarını hep birlikte göreceğiz.

10 Mart 2016 Perşembe

Nesnelerin İnterneti (IoT) Konsepti ile Yeni Bir Çözüm - Otellerde Akıllı Minibar Projesi

Dünyanın bir çok ülkesinden konukların ağırlandığı ve aralarında gazetecilerden otel sahiplerine, mimarlardan yatırımcılara, havayolu şirketlerinden yeni teknoloji çözüm sahiplerine kadar bir çok değerli girişimcinin yer aldığı World Tourism Forum etkinliği geçtiğimiz günlerde Lürfi Kırdar'da düzenlendi.


http://www.worldtourismforum.net/

Oteller için akıllı minibar teknoloji çözümleri sunan ve önümüzdeki günlerde çok daha fazlasını hedefleyen Prohotech firmasıyla birlikte biz de etkinlikte yerimizi aldık.

Prohotech, sunmuş olduğu akıllı minibar sistemleri sayesinde otellerin minibar operasyonlarını optimize etmeyi, maliyetleri düşürmeyi, güvenliği arttırarak kayıpları azaltmayı hedefliyor. Bu vesile ile standuplara bile mevzu olan, otel misafirlerinin korkulu rüyası minibarlardaki ürün fiyatlarında da ciddi indirimler yapılabilecek. Hem sunulan hizmetin karizması hem güvenliği hem de talep edilebilir liste fiyatları sayesinde müşteri memnuniyeti de hat safhada olacağa benziyor.

Microsoft Nesnelerin İnterneti (IoT - Internet of Things) teknolojileri ile (Azure IoT Suite) desteklediğimiz bu projenin faydalı olacağına inanıyoruz.

Prohotech çalışanlarının inançları, çabaları ve geniş ufukları taktire şayan. Başarılarının devamını diliyoruz.

Akıllı minibar projesinde uygulanan topoloji şöyleydi:


Fuardaki stanttan bir kaç görüntü:
Abdullah Kise


Kullandığımız teknolojiler ve ürettiğimiz raporlardan bir kaçı:

ve fuarda geçirdiğimiz eğlenceli günlerden bir kesit:

Abdullah Kise
Abdullah Kise
Abdullah Kise

Bu arada hedefte olanları ben attım. Diğerlerini başka bir arkadaş atmış :)

Nesnelerin İnterneti (Internet of Things - IoT) konsepti hakkında bir şeyler okumak isterseniz şu linke göz atabilirsiniz:

http://abdullahkise.blogspot.com.tr/2015/08/nesnelerin-interneti-iot-ile-yeni-akll.html


1 Şubat 2016 Pazartesi

NoSQL Dünyası - 2 (Veri Tutarlılık Modelleri ACID vs BASE)

Serinin bir önceki yazısında geçmişten bu güne verinin evriminden bahsettik. Yeni cesur dünyaya gelene kadar değişen taleplerin nasıl yönetildiğini, ortaya atılan sistemlerin güçlü ve zayıf yanlarının neler olduğunu özetledik.

Önceki yazıya göz atmak isterseniz şu linki kullanabilirsiniz:
http://abdullahkise.blogspot.com.tr/2015/03/nosql-dunyas-1-veri-yonetiminin-evrimi.html

Geldiğimiz noktada temel olarak iki ayrı talep karşımıza çıkmakta;

  • Ya verilerimiz son derece tutarlı olacak 
  • Ya da arıza bile olsa işlemlerimiz kesintiye uğramadan sistem son derece hızlı çalışacak.


Artan hız tutkusu, büyüyen ve çeşitlenen veri, kalabalıklaşan kullanıcı kitlesi gibi parametreler alt yapıya maliyetli yatırımlar yapmayı gerektirdi. Bu parametre değerlerinin dönem dönem farklılık göstermesi de alt yapı hazırlığındaki zorluğu bir kademe daha arttırdı.

Bir önceki yazımızda değindiğimiz gibi bu parametreler karşısında sisteminiz için iki tür ölçeklendirme yapabilirsiniz:

  1. Dikey Ölçeklendirme (Vertical Scaling - Scale Up) : Tek bir cihaza CPU, Memory gibi daha fazla kaynağın eklenmesi anlamına gelir. Sanallaştırma teknolojisi bu işlemlemi bir nepze olsun kolaylaşmıştır.
  2. Yatay Ölçeklendirme (Horizontal Scaling - Scale Out) : Sisteme görece daha ucuz bir çok cihazın bağlanması anlamına gelir.


Tek bir bilgisayarı güçlendirmek ve onunla çalışmaya devam etmek çok temiz görünüyor olabilir. Ancak bu şekilde güçücünüz bir yere kadar yetebilir. Tek bir süper bilgisayarın tüm dünya taleplerine cevap vermesi mümkün değildir (en azından şimdilik.).  Dakikalar içerisinde terebaytlarca veri türetilebilen milyonlarca kullanıcının memnuniyetinin devam ettirildiği sosyal medya sistemlerinin arkasında tek bir makine olduğunu düşünebiliyor musunuz? Böyle bir süper bilgisayar çok pahalı olurdu. Ayrıca bu cihazın başına bir şey gelme ihtimali gücüne olan güveni yerle bir ediyor.

Bu durumda yatay ölçeklendirme daha mı mantıklı acaba? Yatay ölçeklendirme için bir araya getirdiğiniz cihazlar gelen talepleri güçlerini birleştirerek cevaplayabilirler. Harika! Peki bu cihazlar arasındaki iletişimde bir aksama olursa ne olur? Sistem durur mu? yoksa veri kaybına göz yumulur hayat devam mı eder? Cevapları yazının devamını okuyarak siz verebilirsiniz.

eTrade'in açıklamasına göre 1 saatlik kesintileri 8 milyon dolara tekabül ediyor. Dell 10 saatlik kesintisinin kendilerine 83 milyon dolara mal olduğunu ifade ediyor. Amozon'un 100 mili saniye daha hızlı çalışması karlarını %1 arttırabiliyor. Düşük performans, kesinti ve veri kaybı çoğu zaman kolayca tolere edilemeyecek sonuçlar doğurur.

En başta belirtiğimiz iki temel talep; tutarlılık ve erişilebilirlik, veri yönetim sistemlerinde iki farklı türde modelin doğmasına sebep olmuştur. Bunlar ACID ve BASE modelleridir.

ACID Modeli


Geleneksel veritabanı ile çalışmış olan hemen hemen herkesin aşina olduğu bir modeldir. Bu modelde çalışan sistemler tutarlılık konusunda son derece hassastır ve veri kaybına oldukça pesimist yaklaşır. ACID, yeteneklerini ortaya dökebilmek için kilit mekanizmalarını kullanır. Bu mekanizmalar verinin diskte ve memoryde tüm kullanıcılar tarafından aynı görünmesini, verinin güncellenmesi sırasında onay gelene kadar tüm istemcilerin bekletilmesini mümkün kılar. Gerekirse tüm veritabanı kilit altına alınır. Gerektiğinde çakışan işlemlerin en maliyetli olanı hariç hepsi iptal edilir. Tabi ki pesimistlik seviyesine müdehale edebilirsiniz. Ancak ACID pesimist olması için dizayn edilmiştir.

Bu yaklaşım, verileri denetim altında tutan lock ve latch mekanizlarını kullanarak veri bütünlüğünü son derece güvenli noktaya taşımıştır. Hızdan daha çok veri tutarlılığının ön planda olduğu, özellikle paraya dokunan işlemler için ACID vazgeçilmezdir. 

Şu sözü her hatırladığımda hak veriyorum; Güçlü yanlar aynı zamanda zaafları doğurur. Çoğu zaman dikey ölçeklendirmede bazen de yatay ölçeklendirmede karşımıza çıkan bu modelin yetenekleri sistemleri hız konusunda adete boğazlamaktadır.

ACID, baş harflerini aldığı şu prensipleri garanti eder:
  • Atomicity: Ya var ya yok prensibidir. Mesela bir banka havalesi yaptınız. Eğer havale işlemi gerçekleşmişse, sizden para eksilmiş, karşıya para eklenmiş demektir. Bunlardan biri hatalıysa havale işlemi geri alınır. Her şey havale öncesi haline döner. Paranız cebinizde kalır.
  • Consistency: Yapılan işlemin mantıklı ve tutarlı olması prensibidir. İsteklerin veriyi bir tutarlı durumdan başka bir tutarlı duruma sokması gerekir. Ben 5 liralık havale yaptım, karşıya 2 lira gitti gibi bir şey söz konusu olamaz. Benden 5 lira eksildiyse karşıda da 5 lira artmalıdır. 2 lira görünüyorsa hesap özetine bakmakta fayda var. Bankanın o arada yaptığı başka bir hinlik olabilir.
  • Isolation: İşlemin diğer işlemlerden izole olması prensibidir. Havale işlemi devam ederken veya henüz ben gönder onayını vermemişken kimse ne gönderiyor olduğumu bilemez. (Çeşitli Isolation Level'ler ile bu prensip esnetilebiliyor.)
  • Durability: Yapılan işlemlerin kalıcı olduğunu ifade eden prensiptir. Verinin son halini sistem kayıt altına alır. Onay sonrasında bir sistem hatası bile olsa yeniden başlatıldığında verinin en son hali yerli yerindedir. Yani havale yaptınız karşıya para gitti ve yerine ulaştı. Sistem çökse bile paranız yerine ulaşmış demektir. Ancak verinin bulunduğu depolama alanı zarar görmüşse geçmiş olsun. Bu ACID'in garanti ettiği bir şey değildir. O sadece depolama aygıtınız sağlıklı çalıştığı sürece garanti verebilir. Bu aşamadan sonrası IT ekibinin Disaster Recovery yeteneklerine ve elindeki imkanlara kalmış demektir.
Özet olarak ACID tutarlılık konusunda çok güçlüdür. Ancak kilit mekanizları çok fazla denetim yaptığı için sistemleri hız konusunda oldukça zayıf düşürmektedir. Geleneksel veritabanlarında (RDBMS) sıkça karşılan bir durum.

Hemen yeri gelmişken söyleyelim; SQL Server tarafında en azından bir kısım işlemler için bu zaaftan kurtulabilmek adına InMemory konsepti hayata geçirilmiştir. Hekaton adıyla duyurulan bu konseptte lock ve latch yer almamaktadır. Böylece 100 kata varan performans artışı elde edilebilmiştir.

Tutarlılığın ön planda olduğu özellikle paraya dokunan yerlerde ACID vazgeçilmezdir. Eğer benim için sosyal medya projelerinde olduğu gibi tutarlılıktan daha çok hız önemli diyorsanız, o zaman felsefenizi değiştirmeniz gerekir. Bu durumda BASE size ilaç gibi gelecektir.

BASE Modeli


Yatay ölçeklenmiş sistemlerde karşımıza çıkan bu modelde ACID'de olduğu gibi kilit mekanizmaları yer almaz. Tutarlılık konusunda son derece optimist bir yaklaşım söz konusudur. Bazı teknikler sayesinde tutarlı bir sistem kurulabilse de bu modelde asıl önemli olan taleplere hızla cevap verebilmektir. Sistemin büyüklüğüne ve sağlık durumuna bağlı olarak veri tutarlılığı yerlerde sürünebilir. Bir makinede arkadaşlık isteğini kabul ettiğiniz kişiye diğer makineden hemen baktığınızda isteğinin kabul edilmemiş olduğunu görmeniz muhtemel. Tabi ki kısa bir süre sonra onay tüm cihazlardan görünür hale gelir.

BASE, "Basically Available Soft-state services with Eventual-consistency" ibaresini ifade eder.
Yani, sürekli ayakta olan bu sistem kullanıcıların isteklerine hızla cevap verir. Veri tutarlılığını garanti etmez. Bir süre sonra veriler tüm sistemde tutarlı duruma gelir. Tutarlılık sağlanana kadar talebin yönlendiği cihazın elinde ne varsa istemciye o iletilir.

Yukarıdaki ibaredeyi ele alırsak;
  • Basic Availability: Sistem CAP teoremine uygun olarak sürekli çalışır (CAP teoremine sonraki yazımızda odaklanacağız). Her bir talebe cevap verir. Fakat bu zorunluluk bir hata durumunda bile geçerli olduğu için veri tutarlılığını garanti etmez ve tüm veriye erişimi mümkün kılmaz. Yani bir nevi verinin bir kısmından feragat etmek suretiyle daha basit bir erişilebilirlik hizmeti almış olursunuz.
  • Soft State: Verileri yazılır ancak tutarlı olmayabilir. Bu developerin görevi olarak görünür. Ayrıca veriler tüm cihazlarda aynı şekilde görünmesi garanti edilmez. 
  • Eventualy Consistency: İşlemlerin etkileri sistemin durumuna bağlı olarak ancak bir süre sonra diğer cihazlara yansır. Yani neredeyse tutarlı bir sistem.
Kim bu modelde çalışmak ister ki demeyin. Günlük hayatta her yanımızı saran  sosyal medya bu model sayesinde milyonlara hizmet verebilmektedir. Birbirine bağlı binlerce cihazdan yüzlercesi gün içinde arızalanır. Fakat hizmet kesintisiz devam eder.

Peki, Ara Çözümler Var mı?


Yukarıda ACID ve BASE modellerinin varsayılan çalışma şekillerini anlattık. ACID modeli içerisinde "Isolation Level" tercihi çalışma şeklinizi BASE modeline benzetmenize olanak tanır. Benzer şekilde BASE modelindeki çalışma şekliniz de master kullanımı, kendi yazdığını okuma ve oy çokluğu gibi teknikler sayesinde ACID modeline benzetilebilir.

Yani bazı konfigrasyonlar sayesinde modeller birbirine yakınsayabilir. Ancak BASE yatay ölçeklenebilen NoSQL dünyasının, ACID ise dikey ölçeklenebilen geleneksel RDBMS dünyasının felsefesidir. Tabi istisnalar da mevcut. Mesela bazı NoSQL(NewSQL) veritabanları ACID'i destekler. Neo4J gibi.

Bu yazımızda veri tutarlarlılık modelleri olan ACID ve BASE'i ele aldık. Tutarlık (Consistency) ve erişebilirlik(Availability) ihtiyaçları göz önünde bulundurularak bu modeller arasında geçiş yapılabilir veya modeller bir yere kadar esnetilebilir. Tutarlılığın olduğu köşeyi ACID, erişebilirliğin olduğu köşeyi BASE almış durumda. Dikey ölçeklendirme dünyasında ACID, yatay ölçeklendirme dünyasında BASE hüküm sürmekte. Projelerinizi bu iki modelin karakterine bağlı olarak geliştirirsiniz. ACID tarafında kalmanız gerekiyorsa geleneksel RDBMS veya NewSQL teknolojilerine, BASE tarafında kalmanız gerekiyorsa NoSQL veya daha kapsamlı BigData teknolojilerine odaklanmanız gerekir.

Bir sonraki yazımızda BASE'in bu tembel tutarlılık yaklaşımının kaynağı olan ve birden fazla cihazın birlikte çalıştığı ekosistemde karşımıza çıkan CAP teoremini ele alacağız. Hem ACID hem BASE CAP teoremiyle ilişkilidir.

Serinin Devamı;
NoSQL Dünyası - 3 (CAP Teoremi)
http://www.abdullahkise.com/2017/01/nosql-dunyas-3-cap-teoremi.html