InMemory DW etiketine sahip kayıtlar gösteriliyor. Tüm kayıtları göster

12 Nisan 2016 Salı

SQL Server 2016 Yenilikleri - 3 (Operational Analytics)

SQL Server 2016 Yenilikleri Serimizin ilk iki yazısında InMemory OLTP ve InMemory DW (ColumnStore) alanında duyurulan gelişmelerden bahsetmiştik. Yazılara bir göz atmak isterseniz aşağıdaki linkleri kullanabilirsiniz

InMemory DW (ColumnStore) tarafındaki gelişmeler için:
http://abdullahkise.blogspot.co.uk/2016/03/sql-server-2016-yenilikleri-1-in-memory.html

InMemory OLTP (Memory Optimized) tarafındaki gelişmeler için :
http://abdullahkise.blogspot.co.uk/2016/03/sql-server-2016-yenilikleri-2-in-memory.html

Bu yazımızda iki alandaki gelişmeleri bir araya getireceğiz ve gerçek zamanlı analizler yapabildiğimiz 'Operational Analytics' konseptinden bahsedeceğiz.


Önce biraz geçmişe bakalım


Geleneksel bir sistemde Insert, Update, Delete iş yükünü karşılayan veritabanlarında normalizasyon kuralları uygulanır. I,U,D işlemlerinin optimum kalitede yapılabildiği bu veritabanı modelleri OLTP kısaltmasıyla anılır. Sıklıkla iş süreçlerinin takibi için kullanılan sistemler zamanla çeşitlenir ve farklı mantıklarda tasarlanmış birden fazla OLTP kaynak, yamalanmış sürecin bir parçası olur.

Sonra bu kaynaklardaki veriler iş kararları vermek amacıyla ele alınmak istendiğinde işin içinden çıkılamaz. Çünkü artık kaynaklar arası bir standart kalmamış, veriler kirlenmiştir. Bu durumda devreye veriambarları girer. Veriambarları (DW, DWH) analiz etmeye yani SELECT etmeye en müsait şekilde modellenmiş veritabanlarıdır. Veriler  ETL dediğimiz veri aktarım ve dönüştürme süreçlerinden geçirilerek bir takım ara katmanlara, sonrasında da veriambarına aktarılır.

Veriambarlarında verinin kolayca analiz edilebileceği Dimensional Model yaklaşımı benimsenir. Artık elimizdeki sistem bir OLAP sistemi olarak anılır. Tabi daha fazla hız ve esneklik bekleyenler için bir adım daha atılır; OLAP Cubelerinin oluşturulması (Multidimensinal, Tabular). En basit söylemle Cubeler veriyi, yapıyı ve ek hesaplamaları üzerinde tutar. Böylece önceden hazırlanmış veriye bir nevi koordinat sistemi mantığıyla erişmek mümkün olur. Tekrar tekrar hesaplama yapılmaz. Bundan sonraki aşamada da veri bir takım raporlama araçlarıyla görüntülenebilir.

Bahsettiğimiz bu geleneksel sürecin avantajları olduğu gibi dezavantajları da var. Bu dezavantajlara kısaca değinelim:

  • ETL İşlemlerinin yükü:
Öncelikle verileri temizlemek ve standartlaştırmak için ETL işlemleri yapmanız gerekir. Bu işlemler bazen çok karmaşık olabilir. Bunun yanında sisteme girilen verinin raporlanması için belli bir süre geçmesi gerekir. Bazen bu gecikme dakikalar seviyende, bazen de günler seviyesinde olabilir.

  • Küplerin 'Process' edilmesi:
Kaynaklardan veriambarına yapılan aktarımlar ETL süreçlerinde ele alınır. ETL süreçlerine benzer şekilde veriambarından 'OLAP Cube'lerine de veri aktarımı yapılır. Bu sürece Cube Processing denir. Benzer şekilde burada da bir karmaşıklık ve gecikme söz konusudur.

  • Yazılım, Donanım, Geliştirme ve Bakım planı:
Sistemdeki karmaşıklık hem geliştirme hem de bakım planının ciddi şekilde ele alınmasını gerektirir. Verinin çeşitli kademelere aktarılması ve çoğaltılması yazılım/donanım yatırımı konusunda titiz olmayı gerektirir.

Özetlersek; geleneksel analitik sistemlerde veri çoklanır ve verinin gelmesi için zamana ihtiyaç vardır. Maliyetli ve yavaş (en azından gerçek zamanlı sayılmaz) bir sistem.

Tabi ki, eğer birden fazla kaynak varsa, bunları bir araya getirmek için veriambarı tasarlamak çoğu zaman en sağlıklı ve en güvenli yol olur. Bazen bu adım atılmadan sistemde performans artışı sağlanamayabilir. 

Index, paralelizm vb. konfigurasyonların yetmediği yerlerde okuma ve yazma iş yüklerini ayırmak genellik net çözümdür.

Veriambarı zorunluluğunun olduğu sistemlerde gerçek zamana yakın bir raporlama yapmak için veriambarından raporlama yapılır. OLAP Cube'lerinin avantajlarından faydalanmak isteniyorsa, Multimensional için sadece yapının korunduğu, verinin veriambarından her defasında temin edildiği ROLAP modu, Tabular için benzer şekilde verinin veriambarından temin edildiği DirectQuery modu tercih edilir. Böylece yapı her ne kadar OLAP Cube olsa da veri veriambarının performansına ve güncelliğine bağlı olarak sunulur. Geleneksel sistemlerin gerçek zamanlı raporlama konusunda geldiği nokta özetle buydu. 


Oyuna sonradan dahil olan çözümlerle düşünelim


SQL Server 2012 ile duyurulan 'ColumnStore Index'ler zamanla gelişti ve Select konusunda 100 kat performans sunan InMemory DW çözümü, SQL Server 2016 ile birlikte son derece başarılı bir noktaya ulaştı. Benzer şekilde SQL Server 2014 ile birlikte duyurulan InMemory OLTP'de 'Memory Optimized Table'lar üzerinden INSERT, UPDATE, DELETE konusunda 30 kat'a varan performans sunabildi ve geliştirilerek SQL Server 2016 ile birlikte bir çok prangadan kurtuldu.

Artık Disk Based bir tablo ve/veya Memory Optimized bir tablo üzerinde RowStore veya ColumnStore index kullanmak mümkün. Bu indexleri belli şartlar altında çeşitli kombinasyonlarda kullanarak hem yazma iş yükünü hem de okuma iş yükünü aynı tabloda toplayabiliriz. Bu durum yüksek performansın sonucu olan gerçek zamanlı raporlama yapmaya imkan verir. Artık raporlarınızı ister bu tablodan isterseniz direk tabloya erişimle veri getirecek şekilde konfigure edilmiş OLAP Cubelerden gerçek zamanlı olarak elde edebilirsiniz. Böylece bir takım senaryolar için ETL ve DW süreçlerine ihtiyacınız kalmaz. Veri doğrudan gerçek zamanlı olarak kaynaktan temin edilir.


Nasıl yapılır?

  1. Operasyonel işlemlerin yüklendiği tablo RowStore veya Memory Optimized olabilir.
    • INSERT, UPDATE, DELETE performansını arttıracak bir çok ipucu var. Mesela BTree indexleri kaldırabilirsin (bunun yerine ColumnStore tavsiye edilir.), constrainleri kapatabilirsin, flagler kullanabilirsiniz vs.
    • Memory Optimized tablolar IUD işlemlerinde 30 kat performans sunar. Kısıtlar göz önünde bulundurularak bu tür tablolar tercih edilebilir.
  2. Yavaş değişen (Warm) veriler için filtrelenmiş (Where koşulu ile belli şarttaki verilerin indexlendiği) Nonclustered ColumnStore indexler tanımlanabilir (Şimdilik Memory Optimized tabloda filtreleme özelliği kullanılamıyor). 
    • Mesela girilen siparişlerden sadece teslimat bekleyenleri filtrelemek isteyebilirsiniz. Sadece ihtiyacınız olan aralık indexlenmiş olur. Böylece fragmantasyonu en aza indirmiş olursunuz. Daha az veri yazıldığı için yazma performansına olan negatif etki en aza iner.
    • İhtiyaç duyulan diğer noktalar için de RowStore indexler kullanım amacı ve yetenekleri göz önünde bulundurularak tanımlanabilir.
  3. Çok sık güncellenen kısım için (Hot) Btree index, daha az güncellenen (Warm) veya neredeyse hiç güncellenmeyen kısım için (Cold) (Daha çok okuma yapılan) ColumnStore index tanımlanabilir. 
    • Burada asıl mesele doğru indexi fazla yük getirmeyecek şekilde doğru aralık için kullanmaktır. Tabi ek olarak Query Optimizer da en verimli yolu tercih edecektir.
    • ColumnStore indexlerdeki fragmantasyonu azaltmak için COMPRESSION_DELAY ifadesi ile sıkıştırma işlemini dakika cinsinden geciktirmek mümkün. Böylece her 1 milyon satır için sıkıştırma işlemi yapmak yerine, istenen aralıklarda buna vakit ayrılabilir.
Bir sipariş sistemini düşünürsek:
  • Alınan siparişler - Çok sık veri girişi olur (Hot Data) - Memory Optimized tablo önerilir.
  • Teslimatı bekleyenler - Zaman zaman durumlarında değişiklik olur (Warm Data) - Filtrelenmiş NonClustered indexler önerilir.
  • Teslim Edilmiş Siparişler - Neredeyse hiç değişiklik olmaz (Cold Data) - Filtrelenmiş ColumnStore önerilir.

Özetlemek gerekirse;

Senaryonun gereklilikleri göz önde bulundurularak, InMemory OLTP, InMemory DW ve geleneksel performans arttırıcı yöntemler bir araya getirilirse maksimum yazma ve maksimum okuma avantajı elde edilebilir. Böylece ETL ve DW süreçlerine gerek kalmadan yazma ve okuma iş yükünü üstlenebilen bir tablo üzerinden gerçek zamanlı raporlama yapmak mümkün olur.

SQL Server 2016 ile birlikte çok gelişmiş araçlar elimizde olacak. Bunları doğru şekilde bir araya getirdiğimizde etkileyici kazanımlar elde edeceğimiz aşikar.


22 Mart 2016 Salı

SQL Server 2016 Yenilikleri - 1 (In-Memory DW - Updatable ColumnStore Indexes)

Bu sene SQL Server 2016 ile birlikte veritabanı dünyamıza heyecan veren yeni özellikler dahil oluyor. Microsoft'un son bir kaç senedir depar attığı Advenced Analytics ve Big Data konseptlerinin etkisini SQL Server ürününde de görmek bizleri mutlu ediyor.

Bazı özellikler önceki versiyonlardaki haline göre geliştirilmişken, bazı özellikler tamamen yeni. Özellikle önceleri sadece appliancelarda var olan Polybase engineı şimdi SQL Server'ın kurulabildiği tüm cihazlarda kullanılabilir durumda. Bu özellik büyük veri ile ilişkisel veritabanının birlikte çalışmasına olanak tanıyor. Hatta veritabanı ile çalışma alışkanlıklarınızı açık kaynakta olduğu gibi dramatik şekilde değiştirmenize gerek kalmadan bunu yapabiliyorsunuz.

SQL Server 2016'da bir çok etkileyici özellik mevcut. İşte bazıları;

  • Open Source R desteği ile analitik çalışmalarınızı yaygın ve güçlü bir dille gerçekleştirmeniz artık mümkün. 
  • Çok az maliyetle verilerinizi daima şifreli tutabilir ve sadece istediğiniz uygulamalarda şifresiz görüntüleyebilirsiniz.
  • Alışkın olduğumuz SSRS ile DataZen bir araya geldi. Böylece hem klasik raporlama hem de Mobile raporlama yaparak bunları tek bir çatı altında toplamak artık mümkün.
  • Geliştirilmiş In-Memory konsepti ile operasyonlarnıza ait verileri gerçek zamanlı olarak analiz edebilir ve raporlayabilirsiniz.

Biz de bu yazımızda In-Memory DW - Updatable ColumnStore Indexes yeniliklerine yoğunlaşacağız.

ColumnStore indexi SQL Server 2012 ile birlikte duymaya başladık. İlk olarak Update edilemeyen NonClustered ColumnStore index ile tanışmıştık. Sonra SQL Server 2014 ile birlikte Update edilebilir Clustered ColumnStore index ile tanıştık. Önceki verisyonlarda bir çok kısıt mevcuttu. 

Daha önceki yazımızda konu hakkında bir hayli bilgi vermiştik. ColumnStore indexler hakkında şu yazımızı incelemenizi tavsiye ederim:


Bu konuda bir de webcastimiz vardı:


Biz bu yazımızda daha çok yeni özelliklere yoğunlaşacağız.

ColumnStore indexler, RowStore indexlere göre açık ara performanslı. İstatistikler vermek gerekirse; 100 kata varan hız, 15 kata varan sıkıştırma elde etmek mümkün. Önceki yazımızda belirtiğimiz gibi 100 milyon satırın 30 dakika yerine 2 veya 3 saniyede elde edildiği referanslar arasında mevcut.

Bu performans farkını şu 3 özellik üzerinden önceki yazımızda açıklamıştık:
  1. Fiziksel Yapısı : Genelde sorgularımız kolon bazlı olur. RowStore indexler tüm satırı indexlerken, ColumnStore indexler sadece ilgili kolonun verilerini indexler. RowStoreda kullanılan pagelerine yerine ColumnStoreda segmentler kullanılır ve segmentler yüksek sıkıştırma özelliği sayesinde çok daha az yer kaplar. Böylece tam olarak ColumnStore indexlerden istediğimiz veriler elimize ulaşır. RowStoredaki gibi ilgilenmediğim kolonların olduğu pagelerde vakit kaybedilmez.
  2. Batch Mode : Normalde Query Optimizer verileri satır satır işler. Ancak gelen SQL Server 2012 ile birlikte bazı sorgu operatörleri bir grup satırı (çoğu zaman 900 satır) birlikte işleyebilecek şekilde tasarlanmıştır.
  3. Segment Eleme: Sayısal ve tarihsel alanlarda işe yarayan bu özellik sayesinde sadece verdiğimiz aralıkta bulunan verilerin olduğu segmentlere gidilmektedir. Böylece daha az IO yapılır. Her bir segmentte minimum maksimum değerin metadata olarak tutulması buna imkan verir. Eğer istenen değer bu aralıkta değilse segment elenir. Sadece şartımıza uyan segmentler belirlenerek içeriği okunur.

Gelelim SQL Server 2016 ile birlikte karşımıza çıkan ColumnStore indexlere:


  1. Performans farkını ortaya çıkaran yukarıdaki 3 özellik aynı şekilde işliyor. Buna ek olarak yeni Batch Mode çalışma desteği veren operatörler duyuruldu. Bunlar: SORT, COUNT/COUNT, AVG/SUM, CHECKSUM_AGG, STDEV/STDEVP, COUNT, COUNT_BIG, SUM, AVG, MIN, MAX, CLR, CHECKSUM_AGG, STDEV, STDEVP, VAR, VARP, GROUPING, LAG, LEAD, FIRST_VALUE, LAST_VALUE, PERCENTILE_CONT, PERCENTILE_DISC, CUME_DIST, PERCENT_RANK
  2. Artık ColumnStore (Clustered,NonClustered) indexler update edilebiliyor. Yani veri girişi sırasında indexi kaldırmaya gerek kalmıyor.
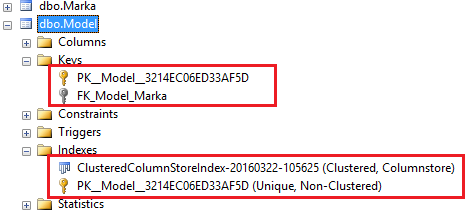
  3. Bu yeni versiyonla birlikte ColumnStore indexlerin bulunduğu tablolarda Pimary Key ve Foreign Key kullanılabilmektedir. (RC0'da test edecek olanlar PK'yı Heap üzerinde, FK'yı da ColumnStore indexten sonra tanımlamalılar.) PK oluşturken Clustered index otomatik oluşacaktır. Clustered yerine NonClustered oluşturalım ki Clustered ColumnStore index ile çakışmasın. Yani PRIMARY KEY NONCLUSTERED ifadesi ile PK oluşturulmalıdır. 
  4. Clustered ColumnStore indexten sonra RowStore (btree) index tanımlamak daha önceki versiyonlarda mümkün değildi. SQL Server 2016 ile birlikte artık hem Clustered ColumnStore hem de birden fazla NonClustered RowStore index tanımlamak mümkün.
  5. Yeri geldiği için hatırlatalım; bir tabloda tek bir Clustered (ColumnStore veya RowStore farketmez) index bulunabilir. Ayrıca bir tabloda birden fazla ColumnStore index tanımlanamaz.
  6. Artık NonClustered ColumnStore indexler filtrelenerek daha efektif kullanılabilmektedi.
  7. Clustered ColumnStore index, Memory Optimized (In-Memory OLTP) tablolarda tanımlanabilmektedir. (RC0'da test edecek olanlar önce Clustered ColumnStore indexi tanımlamalılar.)
  8. Storege Engine seviyesinde yapılan bir diğer geliştirme ise Pushdown (Aggregate Pushdown, String Predicate Pushdown) özelliğidir. Bu özelliği şöyle açıklayalım; Önceki yazımızda da geçtiği üzere veriler segmentlere dönüştürlürken encoding bilgisinin tutulduğu Dictionary nesneleri de oluşur. Segmentler, Dictionary'da tutulan gerçek verilerin giriş numaralarını içerir. Bu teknik sayesinde tekrar eden verilerle ilgili ciddi sıkıştırma performansı elde edilebilir. İki tür Dictionary nesnesi vardır. Primary Dictionary : tüm segmentler tarafından kullanılır. Secondary Dictionary : Birden fazla segment (aynı kolona ait) tarafından paylaşılır. Her zaman Secondary Dictionary kullanılmayabilir. Bazı durumlarda devreye giren Pushdown özelliği sayesinde kritere uygun satırlar Dictionary seviyesinde taranır. Diğer satırlar segment seviyesinde taranır ve filtrelenir. Bu çalışma şeklinin performansı SQL Server 2014 ile karşılaştırıldığında sonuçlar şaşırtıcı derecede farklı olur.         
Aynı sorgu üzerinden testimizi gerçekleştirdiğimizde, SQL Server 2016 istenen sonuçları açık ara önde sunabiliyor.

ColumnStore indexlerin sorgulama performansını incelemek isterseniz şu linke bir göz atabilirsiniz:

Sonuç olarak SQL Server 2016 versiyonu ile birlikte ColumnStore indexlerde hem performans bakımından hem de fonksiyonalite bakımından ciddi iyileştirmeler oldu. Diske bağımlılığın minimuma düşürülmesi hem operasyonel anlamda hem de analitik anlamda iş süreçlerine ciddi katkısı olmaktadır. Bu iyileştirmelerin yeni gelen diğer özelliklere de etkisi var. Sonuçlarını hep birlikte göreceğiz.

19 Haziran 2015 Cuma

Veri Yönetimi Ekibi & 2015 Kış seminerleri - Özgür Erecekler (Web Semineri Kayıtları) - Azure ML ve MSSQL 2014

Veri Yönetimi Ekibinde Kıdemli Danışman olarak görev alan Özgür Erecekler tarafından gerçekleştirilen 2015 kış webseminerlerine ait video kayıtları :

SQL Server 2014 Bellek İçi Veri Ambarı


Özgür Erecekler: "Bu web seminerinde; SQL Server 2014 ile birlikte gelen Clustered Column Store indexler anlatılacaktır. "

Azure Machine Learning’e Giriş


Özgür Erecekler: "Bu web seminerinde; Azure üzerinde Machine Learning uygulamaları örneklerle anlatılacaktır."

Keyifli seyirler...

9 Nisan 2015 Perşembe

Veri Yönetimi Ekibi - SQL Server 2014 Bellek İçi Veriambarı - Web Semineri

SQL Server 2014 ile birlikte In-Memory başlığı alınta iki ayrı yenilik duyuruldu. Bunlar daha çok Insert, Update, Delete performansını şaşırtıcı derecede arttıran In-Memory OLTP ve daha çok Select performansını inanılmaz şekilde arttıran In-Memory DW.

In-Memory OLTP hakkında araştırma yapıyorsanız şu yazımıza da bir göz atmak isteyebilirsiniz:
http://abdullahkise.blogspot.com.tr/2014/01/microsoft-sql-server-2014-ctp2.html

In-Memory DW'den kasıt ColumnStore indexlerdir. SQL Server bu index türü sayesinde klasik indexler (Clustered, Non-Clustered) gibi verileri satır bazlı değil de kolon bazlı olarak tutar. Böylece ihtiyacımız olan verilere ulaşmak için daha az page (segment) okuması yapılır. Böylece yüksek okuma performansı elde edilir. Bu konudaki gerçek dünya örneklerine bir yazımızda değinmiştik.

"Bank of Nagoya’dan direktör yardımcısı Atsuo Nakajima; SQL Server 2012 In-Memory ColumnStore’u kullanarak 100 milyonsatırı 30 dakika yerine artık 2 veya 3 saniyede elde edebildiklerini ifade etmiştir. Başka bir örnekte, star şemanın tercih edildiği bir veri ambarında, 2 milyar satır bulunun fact tablosu kullanılarak üretilen rapor önceden 18 saatte açılmaktayken, ColumnStore teknolojisi sayesinde aynı donanım üzerinde 5 dakikada açıldığı gözlemlenmiştir. Bir diğer örnekte ise; fact tablosunun tarandığı bir veri ambarından 17 dakikadan fazla sürede elde edilen sorgu sonucunun bu yeni index türü sayesinde 3 saniye civarında getirildiği tecrübe edilmiştir."

http://abdullahkise.blogspot.com.tr/2014/02/sql-server-2014-in-memory-dw.html

ColumnsStore indexleri ikiye ayrılır; SQL Server 2012 ile birlikte gelen Non-Clustered ColumnStore index ve SQL Server 2014 ile birlikte duyurulan Clustered ColumnStore index.

Son versiyonlarla birlikte gelen, veritabanını %27'lere kadar küçülten yüksek sıkıştırma teknolojisi ve 100 kata varan okuma performansı, inanılmaz sonuçlar elde etmeyi mümkün kılıyor.

Bu konu daha önce düzenlediğimiz bir web seminerine ait video kaydına göz atmak isterseniz şu linki kullanabilirsiniz:
http://abdullahkise.blogspot.com.tr/2014/06/bellek-ici-veriambar-inmemory-dw.html

Veri Yönetimi ekibinde Kıdemli Danışman olarak görev alan Özgür Erecekler, ColumnStore index türünden, bu minvalde SQL Server 2014 ile birlikte gelen yeniliklerden ve önceki teknolojilere göre elde edilen avantajlardan bahsediyor olacak. İş zekası tarafında bir hayli deneyimi olan Özgür Erecekler'in bakış açısı ile bu konuları incelemek kaçırılmayacak bir fırsat.

10 Nisan 2015 - Cuma
11:00 - 12:00

Özgür Erecekler

Aşağıdaki link yardımıyla, seminer saatinden 10 dakika önce Live Meeting ile bağlanıp, online olarak katılım sağlayabilirsiniz.

https://msevents.microsoft.com/cui/EventDetail.aspx?culture=tr-TR&EventID=1032612200&IO=SZ9syfU0CRJivPIc715jdA%3d%3d


Duyurunun Orjinali:


Bu web seminerinde; SQL Server 2014 ile birlikte gelen Clustered Column Store indexler anlatılacaktır.

10 Nisan 2015 - Cuma
11:00 - 12:00
Özgür Erecekler

Diğer web seminerlerine ulaşmak ve oturuma dahil olma yöntemini öğrenmek için şu linke bir göz atabilirsiniz:

15 Haziran 2014 Pazar

Bellek İçi Veriambarı (InMemory DW - ColumnStore) Web Semineri - (Video)

11 Haziran 2014 Çarşamba günü gerçekleştirdiğimiz web seminerinde Bellek İçi Veriambarı (In-Memory DW) konusuna odaklandık.

SQL Server 2014 ile birlikte duyurulan InMemory DW, Clustered ColumnStore Indexi işaret etmektedir.

ColumnStore index sadece SQL Server 2014 versiyonda duyduğumuz bir index türü değildir. İlk olarak SQL Server 2012 ile birlikte kullanıma sunulan Non-Clustered ColumnStore index sayesinde veriler artık RowStore ve ColumnStore olarak tutulabilir hale gelmiştir.

Bu web seminerinde ColumnStore formatı, SQL 2012 ile gelen Non-Clustered ColumnStore index ve SQL Server 2014 ile gelen Clustered ColumnStore index arasındaki farkları, Clustered ColumnStore indexin performans testlerini ve kullanım avantajlarını, ColumnStore Archive kullanımı ile ortaya çıkan yüksek sıkıştırma becerisini inceledik.

Önümüzdeki web seminerlerinde canlı ortamda buluşmak koşuluyla, katılamayan, kaydı bekleyen ve InMemory DW konusuna göz atmak isteyenlere keyifli seyirler dilerim.


8 Haziran 2014 Pazar

Bellek İçi Veri Ambarı - InMemory DW (ColumnStore) Web Seminerini kaçırmayın!

SQL Server 2014 ile birlikte InMemory kapsamında iki çözüm duyuruldu. Bunlardan birisi InMemory OLTP diğer ise InMemory DW dir.

Biz bu web seminerinde In-Memory DW'ye odaklanıyor olacağız.

Bu teknolojinin ilk versiyonu SQL Server 2012 ile birlikte kullanıma sunuldu; Non-Clustered ColumnStore Index.

Klasik B-tree indexlerden çok daha farklı çalışan bu yeni index, veriambarı mantığında kullanılan sistemlerde 100 kata varan SELECT performansı vaad ediyor.

Microsoft bu yeni index türü üzerinde biraz daha geliştirme yaparak SQL Server 2014 ile birlikte Clustered ColumnStore indexi kullanıma sundu.

Artık ColumnStore Index sayesinde columnstore veriler hem güncellenebiliyor hem de yüksek sıkıştırma özelliği ile verilerinizin %27'lere kadar küçülmesini sağlıyor.

Özetle bu yeni teknoloji daha az disk alanı harcayıp, çok daha yüksek okuma performansı sunuyor. Hatta hesaplarınız ne kadar karmaşık, talep ettiğiniz satır miktarı ne kadar fazla olursa, normal indexlerle arasındaki performans farkı o kadar açılıyor.

Sistemlerinde okuma performansını arttırmak isteyenlerin bu web seminerini kaçırmamasını öneririm.

Etkinlik Tarihi :
11 Haziran 2014 Çarşamba - Saat 10:00

Bellek İçi Veri Ambarı
İlk olarak SQL Server 2012 ile birlikte duyurulan ColumnStore yapısı SQL Server 2014 te ile birlikte biraz daha zenginleşti. Bu sunumda okuma performansını etkileyici bir biçimde arttıran ColumnStore indexlere odaklanacağız.


Etkinlik için kayıt olun: 
https://msevents.microsoft.com/cui/EventDetail.aspx?culture=tr-TR&EventID=1032583319&IO=EMoQ04fFYzN7yFn5FnIieA%3d%3d

Seminerde görüşmek üzere,